yohei-y:weblog

XML と REST/Web サービス関連の話題が中心の weblog です

2007-11-23

第10回XML開発者の日

今年もXML開発者の日が 12月21日に行われます。 今回は XML 色が強いので、一参加者として楽しみです。

REST関係ではgihyo.jp で AtomPub 解説を連載中なあさくらさんに AtomPub の紹介をお願いしました。AtomPub の Interop にほぼ皆勤賞のあさくらさんにいろいろ面白いお話を聞けるのではないかと期待しています。

ラベル: ,

2007-10-12

AtomPub が RFC 5023 に/日本語訳を公開します

AtomPub がついに RFC になりました!

関係者のブログ

RFC になるまでずいぶんと長かったように感じますが、 その分完成度は上ったのだと思います。 interop もすでに何回も開催されており、その結果も良好です。

AtomPub は全ての、とはいかないまでも、多くの Web サービスのベースとなることが できるプロトコルです。 たとえば blog 、何らかのデータベース、画像/映像リポジトリ、 Wiki、カレンダー、ソーシャルブックマークなど、title/author/updated というメタデー タがあって、その読み書きができるサービスは全て AtomPub ベースの API を 出せる可能性があるでしょう。

さて、そんな AtomPub を会社の同僚と翻訳したので、公開したいと思います。

draft-15 から翻訳を始めたので、比較的長い時間レビューしていますが、 それでもミスや変なところがある可能性はあります。 もし何か問題があれば、ご連絡ください。

AtomPub 実装者の方々の一助となれば幸いです。

追記: 技評さんが gihyo.jp で取り上げてくれた

さらに追記(2007-10-21): WEB+DB PRESS の連載で AtomPub を取り上げています。 今月発売の Vol.41 では AtomPub で導入されたサービス文書やメディアエントリの解説をしています。

photo
WEB+DB PRESS Vol.41
WEB+DB PRESS編集部
技術評論社 2007-10-24

コレクションとエントリの基本を解説した Vol. 40 と合わせてどうぞ。

photo
WEB+DB PRESS Vol.40
WEB+DB PRESS編集部
技術評論社 2007-08-24

ちなみに Vol. 41 では RFC 5023 という番号を紙面に入れることができました。 正にぎりぎりの修正だったのですが、間に合ってよかった。

ラベル: , ,

2007-08-20

いろいろ改め AtomPub の話と、パターンの話と、消費電力の話と、古くて新しい開発環境の話と、Tim Bray のインタビューと、Dave Thomas のTシャツプレゼントが載ってる WEB+DB PRESS Vol.40

WEB+DB PRESS の Vol. 40 が届きました。どうもありがとうございます。

僕は Atom API 改め AtomPP 改め APP 改め AtomPub/Atompub な Atom Publishing Protocol の解説を REST の連載で書きました。 記事のドラフトではずっと APP で通してきたのですが、 最後の最後で AtomPub に切り替えました。 いろいろ考えたんですが AtomPub で統一して呼んでいこうかと。

今回は 40号記念だからか、すごく充実した内容です。 パターンの特集はここまでまとまってるのは今までなかったし、 サーバの消費電力の話なんて、他にどこで読めるのかわからないような記事でした。 僕はどちらかというとソフトウェアの抽象レイヤをいつも考えているので、 たまにこういう物理的な話を読むととても勉強になります。

それにしても id:naoya 氏はどんだけ記事書いてるんだと小一時間問い詰めたい。 はてなのCTOはよっぽど暇なのかそれとも文章書くのが速いのか。 まあどう考えても後者ですよね。

…という微妙な DIS はともかく、 新人さんとか向けに古くて新しい unix 開発環境を整えさせるにはとてもよい導入記事だと思います。

それからなにげにニュースのところに Tim Bray のインタビュー記事が載ってますが WADL どうよとか聞いていてよいですね(自作自演)。 ちなみに僕は WADL いらない派です。

そしてなんといっても Dave Thomas (とプレゼントの Tシャツ)でしょう。 僕もこれから応募はがき書くところです。 メッセージがまたかっこいい。Tシャツ画像はひろせさんのところで見れます。 プログラミングはやっぱり楽しくなきゃいけないですね。

photo
WEB+DB PRESS Vol.40
WEB+DB PRESS編集部
技術評論社 2007-08-24

ラベル: , ,

2007-07-25

APP の標準化作業がほぼ終了

Tim Bray からアナウンスがあったとおり、 APP の標準化作業がほぼ終了しました。 RFC 番号が付くのはしばらく先だと思いますが、 現状の仕様を実装してもう問題ありません。 最後の draft-17 ベースの仕様が RFC になります。今後の修正は editorial なものだけのはずです。

この先、Web API を設計する人は、まず APP が利用できないか検討しましょう。 APP を採用すれば自然と REST スタイルを採用することになります。 これまで悩みがちだった Web API の設計が、かなり楽になると思います。 Web API を設計する人は、オレオレXMLを設計する前に、Atom/APP をベースにしたらどうなるか、 を考えて見ましょう。きっと Atom/APP は良い選択肢になってくれるはずです。

日本では AtomPP で定着しつつあった Atom Publishing Protocol の略語ですが、 Tim Bray のエントリにあるとおり、 Atom プロトコル、APP、Atompub があちらでは標準的な略語になりつつあります。 とりあえず AtomPP と呼ぶのはやめたほうが、相互運用性の観点から望ましいと思います。

来週月曜には、APP の Interop が日比谷であります。 日本でも APP を盛り上げていきたいですね。

ラベル:

2007-07-20

APP Interop in Tokyo

NTT コミュニケーションズの朝倉さん(実は NAIST の研究室の先輩です)と一緒に 7/30 に Atom Publishing Protocol の接続試験を東京で行います。

http://intertwingly.net/wiki/pie/July2007InteropTokyo

4月に Google Campus で行われたものの日本版です。 今のところ参加する予定なのは

参加されたい方は上記 Wiki に名前を書く、あるいは僕(yoheiy at gmail dot com)までメールください。APP の実装をお持ちの方はぜひ。

ラベル:

2007-06-29

[これはすばらしい] mixi ステーション API。ただ一つ注文が…

via: mixi あしあとAPI発掘

mixi が Atom Publishing Protocl (APP) 対応の Web API を mixi ステーションで利用しているそうだ。

さっそく手元にあった APP クライアントで試してみると 30分くらいであっさりと接続成功。本当に素晴しい。 ざっくりと Web API を見させてもらったのだけれど、 拡張タグの使い方などセンスが良いし、さすがという感じだ。

ただ一点だけ、どうしても直してほしいのは APP の service document の名前空間 URI。 これは http://www.w3.org/2007/app が本番仕様である。mixi の Web API は古い名前空間を使ってる。 中の人はわかっていると思うんだけど、APP はもう少しで RFC になる。 APP を実装する人は必ず RFC になる名前空間 URI を実装しましょう。 mixi の API を真似している人は気をつけてね。

ラベル: ,

2006-08-01

The Atom Publishing Protocol as Universal Web Glue

RSS and Atom in Action の人 Dave Johnson が TriXML 2006 で発表したスライド。74ページより

APP as universal web glue

フィードや APP はもはやブログだけのものではなく、 Atom の提供する entry と collection という汎用 XML と CRUD は Web 全体をつなぐ接着剤の役目を果たし始めていると。 APP を Web サービス基盤として捕らえるのがもう普通になってきた感じです。

ちなみに "The Atom Publishing Protocol as Universal Web Glue" というのは OSCON での Tim Bray のセッションのタイトルですね。

ラベル:

2005-12-12

Atom で件数取得

なんか催促されちゃったみたいなので :-) 詳しく書いてみます。

はてなのブックマーク件数取得 API いいですね。 今さら xml-rpc かよ! というツッコミは置いておいて、 データ重要な世の中で有用なコンテンツ(メタデータ)にリーチする 方法が増えるのは喜ばしいことです。

そうそう、こういう API を AtomPP で実装するとしたらどんな感じなんだろう。そもそもうまくフィードで定義できるのか。教えて偉い人!

偉い人じゃないけど、結論からいえば、 Atom Publishing Protocol (APP) そのままじゃ無理です。 やってもいいけどどうしても無理が出てしまいそう。 そもそも目的が違うのだから、ここは野良 XML/プロトコルでいいのでは。 ただ、結果をフィードで取れるとそれなりに嬉しいかもしれない。

普通 REST で検索するときは query string を使った URI を GET することになる(検索結果リソースを GET する)んですが、 今回の場合のようにパラメータがたくさんあったり長かったりする場合は GET は現実的ではありません。 こういうときは問合せ文書(query document)を POST で投げます。

POST /atom/exist HTTP/1.1
Host: b.hatena.ne.jp
Content-Type: application/xml
Content-Length: xxx

<uri-list xmlns="http://ns.hatena.ne.jp/uri-list">
  <uri>http://d.hatena.ne.jp/naoya/20051212</uri>
  <uri>http://yohei-y.blogspot.com</uri>
</uri-list>

結果はたとえば XML 形式で取れます。

HTTP/1.1 201 Credated
Host: b.hatena.ne.jp
Content-Type: application/xml
Content-Length: xxx
Location: http://b.hatena.ne.jp/atom/exist/1234567890abcdefg

<bookmark-list xmlns="http://ns.hatena.ne.jp/bookmark">
  <bookmark>
    <uri>http://d.hatena.ne.jp/naoya/20051212</uri>
    <count>5</count>
  </bookmark>
  <bookmark>
    <uri>http://yohei-y.blogspot.com</uri>
    <count>4</count>
  </bookmark>
</bookmark-list>

ここでのキモは Location ヘッダで検索結果リソースの URI を返しているところ。 この URI を GET すればいつでもこの検索結果(の最新版)が取得できると。

リクエストとレスポンスは野良 XML でもいいんですが、これくらいの情報なら JSON の方がプログラムから扱いやすくて便利ですよね。実際、グリモンとかから使うなら JSON の方がいいと僕も思います。

ただ、レスポンスの場合、野良 XML じゃなくて Atom フィードだと いいことありそうです。

HTTP/1.1 201 Created
Host: b.hatena.ne.jp
Content-Type: application/atom+xml
Content-Length: xxx
Location: http://b.hatena.ne.jp/atom/exist/1234567890abcdefg

<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>はてなブックマーク検索結果</title> 
  <link rel="self" type="application/atom+xml"
    href="http://b.hatena.ne.jp/atom/exist/1234567890abcdefg"/>
  <updated>2003-12-13T18:30:02Z</updated>
  <author><name>Hatena</name></author> 
  <id>urn:uuid:60a76c80-d399-11d9-b93C-0003939e0af6</id>

  <entry>
    <title>なおやのはてなダイアリー</title>
    <link href="http://d.hatena.ne.jp/naoya/20051212"/>
    <link rel="alternate" href="http://b.hatena.ne.jp/entry/http://d.hatena.ne.jp/naoya/20051212"/>
    <id>urn:uuid:1225c695-cfb8-4ebb-aaaa-80da344efa6a</id>
    <updated>2005-12-13T18:30:02Z</updated>
    <summary>5</summary>
    <content type="xhtml">
      <!-- リンク、キーワード、タグなんかをそのまま入れる -->
    </content>
  </entry>

  <entry>
    <title>yohei-y:weblog</title>
    <link href="http://yohei-y.blogspot.com"/>
    <link rel="alternate" href="http://b.hatena.ne.jp/entry/http://yohei-y.blogspot.com"/>
    <id>urn:uuid:1225c695-cfb8-4ebb-aaaa-80da344efa6a</id>
    <updated>2005-12-10T10:34:02Z</updated>
    <summary>4</summary>
    <content type="xhtml">
      <!-- リンク、キーワード、タグなんかをそのまま入れる -->
    </content>
  </entry>

</feed>

ブックマーク件数は summary に入れるの? とか(summary/content の中で microformats 的にやったほうがいいかもしれない)、いろいろツッコミどころはありますが、雰囲気は伝わるんじゃないでしょうか。

イメージとしては、現在の人間用はてなブックマーク一覧のページで、 表示するブックマークを一つ一つ指定できるようにした感じです。 今のブックマーク一覧ページで取れている情報をそのまま Atom フィードにしたものを想像してもらえればいいでしょう。 カテゴリなど、Atom で用意されている要素はそのまま使ってもよさそうだし、 足りない要素・属性があればはてなの名前空間で足せばいいだけ。

Atom フィードなんで、RSS リーダで購読すれば更新情報も取れます。 自分の気になる記事がどれくらいブックマークされてるかどうか気になる人には けっこう嬉しいんじゃないでしょうか。

まー、フィードは Atom じゃなくて RSS でもいいじゃん、 といわれちゃいそうだけど、RESTful に考えるとこんな風になるという参考までに。

追記: 例のレスポンスのステータスコードを 201 にしました。

ラベル: ,

2005-11-27

山田さんの資料

XML 開発者の日の tai さんの資料をいただいたので公開します。 REST, Atom, and WebDAV

ラベル: , , ,

2005-06-30

はてなブックマークのタグ編集に Atom PP を用いる件について

楽しそうなので、考えてみることにする

なにはともあれはリソースのことを考えよう。 タグをリソースとするならまずはそれに URI を割り当てなければならない。 僕(yohei) の "atompp" というタグの URI は以下のような形式とする。

http://b.hatena.ne.jp/atom/yohei/tag/atompp

次に考えるのはタグリソースの 表現に何を使うか。 構造を持った情報なので XML になるのはすんなり確定。 問題はその形式。候補は以下のとおり。

最新 AtomPP のメンバー要素(member)
長所: 軽い、簡単
短所: member/@href で参照する先の URL はどの XML 形式にする? あるいはタグ名のテキスト(plain/text)か?
Atom の entry 要素(entry)
長所: 標準。使える子要素がいろいろ定義されている
短所: (他に比べて)重い。ブックマークの dc:subject との違いがわかりにくい
独自要素(hatena:tag or dc:subject?)
長所: 自由。簡単
短所: クライアントにとって扱いが難しい。独自すぎる

ここでは entry がいいのではと思うので、それで進めてみる。 entry を選んだのはそのバランスによる。 たとえば entry の子要素にはもちろんタグの更新時刻や利用回数も入れられる。 タグ名は title に入れるのが素直そうだ。

次はこのリソースに対してどんな操作を行うか。 REST 的に考えると必要そうな操作は取得(GET)、削除(DELETE)、更新(PUT)、新規作成(POST)の四つ。 ま、GET と DELETE は必要だろう。 POST で新規作成はいらなさそうだ(タグはブックマーク時に自動的に新規作成されるので)。 PUT で更新できるのはタグ名くらいかな。 タグにコメントなんてつけられなくてもいいよね。

さて、これでタグリソースは固まった。 今度はタグの一覧を考える。 AtomPP 最新最新版ならコレクションという便利なものがあって、 上記どの種類の XML 形式でもひとつのコレクションとして扱える。 でもここではタグリソースをあえて Atom entry にしたので、feed 要素を使ってみよう。

一覧取得のときに、オフセットや取得数、タグ名をワイルドカードや正規表現で検索などをしたい気もするけど、 そういうのはコレクションリソースの URI の query string でやればよさそうなので、 ここでは単純に全タグ取得を考える。

ちなみにコレクションリソースの URI に適用できるのは GET だけ。

以下に例を書いておく。名前空間宣言や X-WSSE ヘッダとか xml:lang とかは省略してるけど許してね。

タグ一覧取得

GET /atom/yohei/taglist HTTP/1.1
Host: b.hatena.ne.jp
HTTP/1.1 200 OK
Content-Type: application/x.atom+xml

<feed>
  ...
  <entry>
    <id>タグの ID</id>
    <!-- Edit URI へのリンク -->
    <link rel="service.edit" type="application/x.atom+xml"
      href="/yohei/atom/tag/atompp" title="atompp"/>
    <!-- title はタグになる -->
    <title>atompp</title>
  </entry>
  ...
</feed>

タグの一括置換というのは要するにタグ名の変更(=リソース title の変更)と考えて、 EditURI に新しいタグ名を PUT する。

PUT /atom/yohei/tag/atompp HTTP/1.1
Host: b.hatena.ne.jp
Content-Type: application/x.atom+xml

<entry>
  <id>タグの ID</id> <!-- いらんか -->
  <title>新しいタグ名</title>
</entry>

タグの一括削除はタグリソースの URI を DELETE する。

あとはタグリソースが URI を持つようになったので、ブックマークリソースのタグ要素(dc:subject or category)からリンクするのがよさそうだ。

ラベル:

2005-06-10

REST -> AtomPP -> blog -> Permalink -> RSS/Atom -> Remixing (Ajax/Microformats/Folksonomy)

少し前の話だが、Blog Hackers Conference 2005 に行った。 miyagawa さんのキーノートも、naoya さんの講演も、キーワードは Web 2.0 (的なもの)だなという印象だった。

中でも特に気になったのはこのスライドで blog が missing piece を埋めた、という話だ。 こちらのコメントにも書いたのだけれど、 ここでいう blog というのはいわゆる weblog system/service だけを指すのではなくて、 blog 周辺の技術 (RSS, Atom, AtomPP, REST, Permalink) が方法論として、プラットフォームとなる、というのがまっとうな解釈であろう。

僕自身もこのような Web 2.0 的なものが現在の主要な関心事になっていて、それをまとめたのがこの図である。
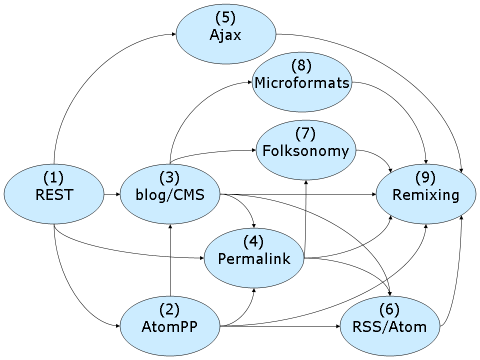
Web2

まず REST。 REST の詳細は REST 入門を見ていただきたいが、 ここでいいたいのは REST アーキテクチャスタイルの Web がすべての基本となる、ということである。 どんなサービスやアプリケーションを作るにしても REST は避けて通れない。

次に Atom Publishing Protocol (AtomPP; いわゆる AtomAPI) である。 AtomPP は REST で足りないところをきれいに補完するものだ。 RESTful Web で URI 経由でリソースに CRUD を適用できるようになっただけでは、まだ難しい。 AtomPP は REST の URI+CRUD でコンテンツをどう編集するかを具体的に規定した(する)プロトコルとして価値がある。 また AtomPP はその汎用性と拡張性から、 80/20 の法則で、ほとんどの Web サービスのベースとなるのではないかと予想する。

次に blog system/cms である。Wiki も含む。 これは REST ベースの AtomPP 上に実現された、まさにプラットフォームである。 blog/cms がもたらした効能はたくさんある。 まず第一に Web 上のコンテンツ作成の敷居を大幅に下げた点。 次に、(X)HTML の長年の夢である文書構造とスタイルの分離を推進した点。 さらにその進化版として、構造化文書+メタデータの作成を簡単にすることも期待される。 そして最も大きいのは各種最新技術のテストベッドとして、 アルファギークの格好のおもちゃとなっている点である。

Permalink は REST の思想のひとつだ。 すべてのリソースはそれぞれ URI を持つ。 もちろんこのときに "Cool URIs don't Change" であるべきだ。 この永続的な URI を手作業で作成・管理していくのは難しい。 昔ながらの Web サイト作りではどうしてもリンク切れが発生する。 しかしそれも blog システムや CMS の普及でツールに任せる時代がやってきた。 また、AtomPP はもちろん Permalink をベースとしている。

みなさんご存知の各種 RSS および Atom Syndication Format はコンテンツ配信、特に syndication が目的だ。 Permalink, blog, AtomPP と組み合わせることで、浮動的なコンテンツを実現する。 (TODO もうちょっと RSS/Atom の本当の価値を検討する必要があるな)

少し毛色が変わって Folksonomy は tagging やはてなブックマークのようなゆるいソーシャルサービスも含む。 こいつがすごいところは、コンテンツ作成者以外にコンテンツとメタデータ作成の門戸を開いたところである。 それまで、ブロガーが独占してきたコンテンツ作成という特権を、 blog を書かない大多数の人々に tagging やコメントという形で開放したところである。 もちろん大勢の人々によるメタデータの補完という価値もある。 ちなみに、ソーシャルブックマークで tagging するためには、もちろん Permalink が必要である。

Microformats が実現するのはコンテンツの更なる細分化である。 Permalink で記事単位になったコンテンツを semantics で分解してプログラムからアクセスできるようになる。 現状では microformat なコンテンツを作成するハードルは高いが、 これは blog/cms がじきに解決する問題だろう。

Ajax、ここはいわゆる Ajax だけじゃなくて greasemonkey とか動的言語とか、そういう気持ちも入っている。 simple で practical な hack 環境。

そして、最後に行き着くところは Remixing Culture である。 REST/AtomPP/Permalink でコンテンツ編集のためのアーキテクチャが整い、 その実装としての blog システムが整備され、 RSS/Atom でコンテンツが再編集しやすい形で配信し、 Folksonomy/Microformats でセマンティクスが補完され、 Ajax で Remix する。

若干酔っ払ってるのでまとまりないですが、最近考えてるのはこんなことです。

ラベル: , , ,

2005-04-05

Java からはてなフォトライフAtomAPIを使う

はてなの技術が今後目指す方向を読んだ。こういう方向性を明確に打ち出せるのがうらやましい。それに比べて自分のやっていることはなんとつまらなくて淋しいことか、と溜息が出てしまうのだった。

こちらの日記のコメントにも書いたけど、REST だの SOA だと騒いでるのは、ごくごく一部の(ちょっとだけ影響力のある)人たちだけで、ニュートラルな立場の人々はそんなことは関係なく次々とウェブサービスで面白いハックを送り出しているのだ。そして現在は、ニュートラルな側(google, amazon, hatena, etc...)が影響力を持つ時代になっている。かつてハードウェアベンダからマイクロソフトに影響力が移ったのと同じように。

僕はもうすぐ30になるけれど(ああ、ついに20代ともお別れか)次の10年を考えなければいけなさそうだ。僕はアーキテクチャの流儀(architectural style)としての REST には重要性があると思っているし、SOA にだって見るべきところがないわけではないと思っている。どちらも学問と現場の間で言えば学問よりの中間層となるだろう。アーキテクチャの流儀ってソフトウェア工学の言葉だしね。でもそれらを仕事を通じて実利を生み出せているのか不安にもなる。もちろん仕事の価値はそれだけではないが、僕にとってのエンジニアとしてのやりがいはそこなのだ。その学問と現場の間をつなぐような仕事がしたい、ということか。そういえば檜山さんのこの文書にも深く共感したのだった。

と、ここまではグチです。

本題は、はてなウェブサービスを Java から使うために必用なX-WSSE ヘッダを扱うライブラリがうまくみつけられなかったので(本当はws-fx の wss4j が妥当だろう)、自分で書いてしまった、というハナシです。といっても、吉松さんの C# 版のコードを参考に Java に移植しただけ…。commons httpclient と commons codec が必要です。言うまでもないけど、僕のパスワードはうそなので、そのまま使っても動かないはず。コメントないけど自由にコピペして使ってください。

import java.io.IOException;
import java.io.UnsupportedEncodingException;
import java.security.MessageDigest;
import java.security.NoSuchAlgorithmException;
import java.security.SecureRandom;
import java.text.SimpleDateFormat;
import java.util.Calendar;
import java.util.TimeZone;

import org.apache.commons.codec.binary.Base64;
import org.apache.commons.httpclient.HostConfiguration;
import org.apache.commons.httpclient.HttpClient;
import org.apache.commons.httpclient.HttpException;
import org.apache.commons.httpclient.HttpState;
import org.apache.commons.httpclient.UsernamePasswordCredentials;
import org.apache.commons.httpclient.auth.AuthScope;
import org.apache.commons.httpclient.methods.GetMethod;


public class AtomTest {
  
  private HttpClient client;
  
  public AtomTest() {
    this.client = new HttpClient();
  }
  
  public void get(String url, String username, String password)
    throws HttpException, IOException {
    GetMethod get = new GetMethod(url);
    get.addRequestHeader("X-WSSE", getWsseHeaderValue(username, password));
    this.client.executeMethod(get);
    System.out.println(get.getStatusLine().toString());
    System.out.println(get.getResponseBodyAsString());
  }
  
  protected final String getWsseHeaderValue(String username, String password) {
    try {
      byte[] nonceB = new byte[8];
      SecureRandom.getInstance("SHA1PRNG").nextBytes(nonceB);

      SimpleDateFormat zulu = new SimpleDateFormat("yyyy-MM-dd'T'HH:mm:ss'Z'");
      zulu.setTimeZone(TimeZone.getTimeZone("GMT"));
      Calendar now = Calendar.getInstance();
      now.setTimeInMillis(System.currentTimeMillis());
      String created = zulu.format(now.getTime());
      byte[] createdB = created.getBytes("utf-8");
      byte[] passwordB = password.getBytes("utf-8");
    
      byte[] v = new byte[nonceB.length + createdB.length + passwordB.length];
      System.arraycopy(nonceB, 0, v, 0, nonceB.length);
      System.arraycopy(createdB, 0, v, nonceB.length, createdB.length);
      System.arraycopy(passwordB, 0, v, nonceB.length + createdB.length,
                       passwordB.length);

      MessageDigest md = MessageDigest.getInstance("SHA1");
      md.update(v);
      byte[] digest = md.digest();

      StringBuffer buf = new StringBuffer();
      buf.append("UsernameToken Username=\"");
      buf.append(username);
      buf.append("\", PasswordDigest=\"");
      buf.append(new String(Base64.encodeBase64(digest)));
      buf.append("\", Nonce=\"");
      buf.append(new String(Base64.encodeBase64(nonceB)));
      buf.append("\", Created=\"");
      buf.append(created);
      buf.append('"');
      return buf.toString();
    } catch (NoSuchAlgorithmException e) {
      throw new RuntimeException(e);
    } catch (UnsupportedEncodingException e) {
      throw new RuntimeException(e);
    }
  }

  public static void main(String[] args) throws Exception {
    AtomTest test = new AtomTest();
    test.get("http://f.hatena.ne.jp/atom", "yohei", "hoehoe");
  }
}

ラベル: ,